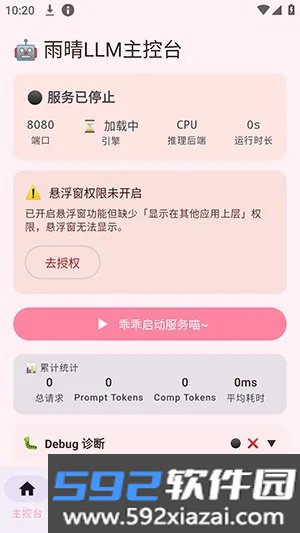
雨晴LLM 是一款运行在安卓手机上的本地离线大语言模型推理服务器,断网状态也能正常使用。它把手机本地部署大模型的门槛降了下来,不用折腾编译环境,启动服务之后,任何兼容 OpenAI 接口的客户端都能直接连上手机端的离线 Gemma 模型。
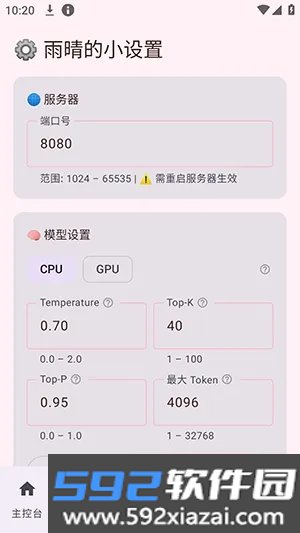
· 推理参数可以自己调,温度、上下文长度、更大生成长度这些选项都开放设置,写创意内容、做逻辑推理、生成代码等不同任务可以各配一套参数。
· 后台推理时对功耗和内存做了管控,长时间跑起来不容易卡顿或闪退,离线推理任务能持续更久。
· 本地 API 服务支持多个客户端同时接入,同一局域网里的其他设备也能访问推理接口,手机可以当作家庭离线 AI 中枢,让多台终端一起调用模型能力。
· CPU 和 GPU 两种推理后端可以随时切换,按手机硬件配置和功耗需求自己选,老设备能兼容,高性能机型也能加速推理。
· 内置 NanoHTTPd 网络服务,在本机开放兼容 OpenAI 规范的 API 端点,聊天前端、自动化工具、脚本程序都能直接对接,接入现有的 AI 软件生态比较省事。
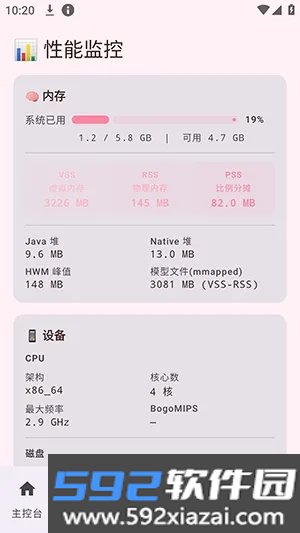
· 实时统计仪表板会用可视化方式展示推理速度、内存占用、负载状态等运行数据,方便随时查看模型状态,按数据调整参数。
1. 安装 APK,授权存储、后台悬浮窗和后台运行权限。
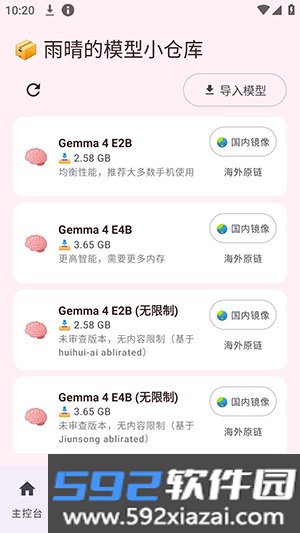
2. 进入模型管理页面,下载对应的 Gemma 量化模型文件。
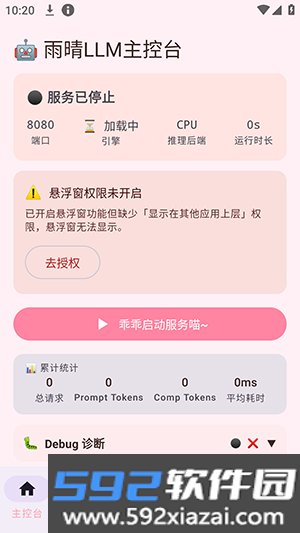
3. 选择 CPU 或 GPU 推理后端,启动本地 API 服务。
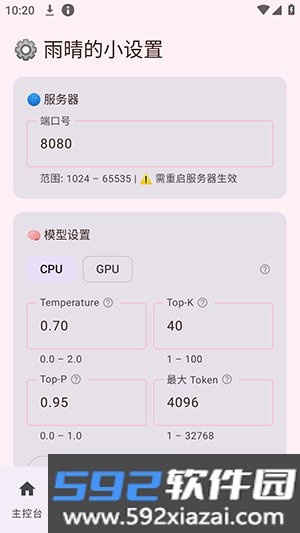
4. 打开任意兼容 OpenAI API 的客户端,填入本地地址 127.0.0.1:8080 就能调用。
5. 悬浮窗可以随时查看生成进度、切换模型、关闭服务。
服务支持持久后台运行,启动推理后切到后台也不会中断,页面退出不影响任务,外部客户端可以持续拿到 AI 接口服务。
模型文件采用独立下载机制,按需获取对应量化规格的 Gemma 权重文件再导入,不强制捆绑内置模型,存储空间和推理效果之间可以自己平衡。
完整兼容标准 OpenAI 对话接口格式,多轮对话上下文、参数自定义都支持,原有云端 AI 程序基本不用改代码就能迁移到手机本地离线运行。
悬浮窗口可以拖动,不用一直停在应用主界面,在任意界面都能快速启停服务、切换模型、查看运行日志,多任务并行操作更方便。
 ELIGA appv3.0.40
大小:52.25MB
查看详情
 小骨检测内核驱动残留appv1.1.0
大小:11.64MB
查看详情
 家谱纪官方版v2.0.6
大小:161.75MB
查看详情
 伟人连点最新版
大小:14.89MB
查看详情
 乐玩组件官方版v1.2.3
大小:71.84MB
查看详情
 教务宝app官方版v12.35.0
大小:18.82MB
查看详情
 靓号玩v1.5.5
大小:42.85MB
查看详情
 linux终端命令行大全v1.1.9
大小:24.92MB
查看详情
 速游加速器v1.0.5
大小:26.51MB
查看详情
 整点报时手机版下载v3.8.389
大小:116.01MB
查看详情